

GPT Image 2.5 ma obecnie lepsze ogólne wyniki benchmarków. Nano Banana 2 nadal warto ocenić pod kątem wykorzystania wyszukiwania, elastycznych formatów obrazów i kosztów generowania. W pracy twórczej istotne jest, który model daje akceptowalny materiał przy najmniejszych kosztach generowania, oczekiwaniu i ręcznych poprawkach.
Porównanie obejmuje trzy modele. OpenAI oferuje GPT Image 2.5 Flare, zoptymalizowany pod kątem szybkości, oraz GPT Image 2.5 Sunburst, zoptymalizowany pod kątem jakości. Model Google Nano Banana 2 to Gemini 3.1 Flash Image. Nano Banana Pro i Nano Banana 2 Lite są innymi modelami. Wskazówki OpenAI dotyczące modeli, Dokumentacja modeli Google.
Badania sprawdzono 5 października 2026. Daty zestawień benchmarków wskazano poniżej. Wygenerowane przykłady ilustrują zadania oceny; nie są punktowanym bezpośrednim porównaniem.
Obsługiwane procesy, źródła premier i szacunki kredytów Quickmake znajdziesz w poradniku Nano Banana 2 i poradniku GPT Image 2.5. Strony rodzin porównują szersze zestawy Nano Banana i GPT Image oraz ich warianty.
Który model wypróbować najpierw?
| Priorytet | Zacznij od oceny | Dlaczego |
|---|---|---|
| Wymagająca grafika końcowa | GPT Image 2.5 Sunburst | Najmocniejsze ogólne wyniki w cytowanych benchmarkach |
| Szybkie iteracje przy wysokiej jakości | GPT Image 2.5 Flare | Konkurencyjna jakość i niższe zmierzone opóźnienie w ImageBench |
| Edycja z obrazem referencyjnym | GPT Image 2.5 Sunburst | Prowadzi w cytowanym rankingu edycji pojedynczego obrazu |
| Generowanie oparte na inspiracjach z internetu | Nano Banana 2 | Udokumentowana integracja wyszukiwania stron i obrazów |
| Bardzo szerokie lub wysokie kompozycje | Nano Banana 2 | Obsługuje proporcje obejmujące 8:1 i 1:8 |
| Najniższy koszt Twoich zadań | Porównaj odpowiadające sobie ustawienia | Wymiary, jakość, obrazy wejściowe i ponowne próby wpływają na wynik |
To wstępne rekomendacje redakcyjne wynikające z poniższych dowodów. Ogólny ranking nie powie, czy model zachowa konkretne opakowanie lub poprawnie wyrenderuje każdy znak tekstu kampanii.
Niezależne wyniki benchmarków
Preferencje obrazów z tekstu w Artificial Analysis
Artificial Analysis mierzy preferencje poprzez porównawcze głosy ludzi. Ranking AA-Image-T2I v2.0, pobrany 5 października 2026, pokazywał:
| Model i konfiguracja | Miejsce | Elo | Podany przedział 95% | Próbki |
|---|---|---|---|---|
| GPT Image 2.5 Sunburst — max | 1 | 1 197 | 1 188–1 206 | 14 212 |
| GPT Image 2.5 Flare — max | 2 | 1 191 | 1 182–1 200 | 13 591 |
| Nano Banana 2 | 6 | 1 125 | 1 117–1 133 | 18 759 |
Obie konfiguracje OpenAI wyprzedzają tu Nano Banana 2. Sunburst i Flare są znacznie bliżej siebie: podane przedziały nakładają się, więc niewielka różnica nie uzasadnia uznania Sunburst za jednoznacznego zwycięzcę wyłącznie na podstawie tego benchmarku. Ranking obrazów z tekstu Artificial Analysis.
Elo opisuje względne preferencje w danej ocenie. Różnica 72 punktów nie oznacza obrazu lepszego o 72%. Wyników z osobnych rankingów nie należy uśredniać ani porównywać tak, jakby używały wspólnej skali.
Wyniki generowania i edycji Arena
Tablica obrazów z tekstu Arena miała datę 24 września 2026. Tablica edycji pojedynczego obrazu pochodziła z 29 września.
| Model | Wynik obrazu z tekstu | Wynik edycji pojedynczego obrazu |
|---|---|---|
| GPT Image 2.5 Sunburst | 1 424 ±8 | 1 522 ±5 |
| GPT Image 2.5 Flare | 1 401 ±8 | 1 478 ±5 |
| Nano Banana 2 — wyszukiwanie w sieci | 1 261 ±4 | 1 387 ±3 |
Pozycje GPT Image 2.5 oznaczono jako wstępne. Wymieniona konfiguracja Nano Banana 2 obejmowała wyszukiwanie w sieci. Te szczegóły mają znaczenie przy porównywaniu wyników z inną aplikacją lub konfiguracją API. Wyniki obrazów z tekstu Arena, Wyniki edycji obrazów Arena.
Wynik edycji uzasadnia ocenę Sunburst jako pierwszego przy wymagającej pracy z materiałami referencyjnymi. Nie potwierdza idealnego zachowania szczegółów, a ranking pojedynczych obrazów nie dowodzi skuteczności w długiej sekwencji edycji.
Możliwości i opóźnienie ImageBench
ImageBench V1.2 ocenia 192 prompty w sześciu kategoriach. Wynik ogólny łączy po równo ocenę możliwości i szacowane preferencje estetyczne; nie jest po prostu odsetkiem udanych promptów.
| Model | Wynik ogólny | Odsetek zaliczonych wymagań | Podane opóźnienie |
|---|---|---|---|
| GPT Image 2.5 Sunburst | 82,1 | 88,0% | 16,9 sekundy |
| GPT Image 2.5 Flare | 81,5 | 86,5% | 13,2 sekundy |
| Nano Banana 2 | 74,9 | 77,1% | 28,1 sekundy |
ImageBench udostępnia wyniki do obejrzenia. Automatyczni oceniający mogą popełniać błędy. Czasy opisują też konkretne konfiguracje: pozycja Google korzysta z punktu końcowego fal/google/, a pozycje OpenAI z openai/. Nie są to gwarantowane czasy odpowiedzi u wszystkich dostawców. Ranking ImageBench i podsumowanie metodologii.
Te pomiary podważają ogólne twierdzenie, że Nano Banana 2 zawsze jest szybsze. We własnym procesie mierz czas od wysłania żądania do otrzymania użytecznego obrazu, uwzględniając ponowne próby.
Jakość obrazu i zgodność z promptem
Ogólne oceny przemawiają za GPT Image 2.5, co czyni go rozsądnym punktem wyjścia dla wymagającego briefu. Efektowny obraz nadal może jednak nie spełniać zadania.
W fotografii produktowej sprawdź sylwetkę, odbicia, cienie kontaktowe i etykietę. Oceń kompozycję w końcowym rozmiarze dostawy: szczegółowa butelka nie wystarczy, jeśli układ nie zostawia miejsca na nagłówek.
W ilustracji redakcyjnej oceń, czy pomysł jest szybko czytelny i czy obiekt pozostaje rozpoznawalny w miniaturze. Obraz o bogatej fakturze może wyglądać efektownie w powiększeniu, a tracić punkt skupienia w mediach społecznościowych.
Zacznij od Sunburst, gdy brief ma wymagające założenia wizualne, a następnie oceń Flare według tych samych kryteriów akceptacji. Zachowaj wolniejszy lub droższy proces tylko wtedy, gdy wyniki go uzasadniają.
Edycja obrazów i zachowanie obiektu
OpenAI dokumentuje poprawę precyzyjnej edycji i zachowania obiektu w obu wariantach 2.5. Google obsługuje edycję obrazów w rozmowie. Ich niezawodność nadal trzeba sprawdzić na własnych materiałach. Wskazówki OpenAI dotyczące promptów obrazowych, Dokumentacja Nano Banana 2.
Przydatny test jest celowo wąski: zmień kolor tła, zachowując produkt, etykietę, kąt aparatu i pierwszy plan. Oceniaj osobno zmieniony obszar i obszary rzekomo niezmienione. Poprawne tło nie rekompensuje błędnie zapisanej nazwy marki.
Przy kolejnych edycjach trzymaj oryginał widoczny obok najnowszego wyniku. Po kilku zmianach ponownie porównaj z oryginałem; oglądanie wyłącznie kolejnych wersji utrudnia zauważenie stopniowego odchodzenia od wzorca. Poniższy przykład produktowy pokazuje, dlaczego to ważne.
Renderowanie tekstu i lokalizacja
Google podkreśla ulepszone renderowanie tekstu i lokalizację wewnątrz obrazów Nano Banana 2, co czyni reklamę wielojęzyczną istotnym zastosowaniem do oceny. Ogłoszenie Google dla deweloperów.
Powyższe ogólne wyniki benchmarków nie wskazują zwycięzcy typografii dla każdego języka. Testuj język, ilość tekstu i wymiary, których faktycznie potrzebujesz.
W plakacie oceniaj pisownię i układ osobno. Poprawne słowa mogą nadal mieć złe odstępy lub nieczytelną hierarchię. Dopracowany układ może zawierać jeden błędny znak. Sprawdzaj interpunkcję, akcenty, liczby i pisma niełacińskie równie starannie jak nagłówek.
W kampaniach produkcyjnych edytowalny tekst pozostaje użyteczny, nawet gdy generator dobrze renderuje litery. Ceny, daty i tłumaczenia łatwiej utrzymywać na osobnych warstwach w edytorze projektów.
Wykorzystanie wyszukiwania i formaty wyjściowe
Nano Banana 2 obsługuje generowanie wspierane wyszukiwaniem stron i obrazów. Udokumentowane opcje rozdzielczości obejmują 0.5K, 1K, 2K i 4K oraz nietypowo szerokie i wysokie proporcje, w tym 4:1, 1:4, 8:1 i 1:8. Specyfikacja modeli Google.
Dlatego warto ocenić je w briefach z inspiracjami wizualnymi z sieci lub panoramicznymi banerami. Traktuj wykorzystanie wyszukiwania jako zaletę danych wejściowych, a nie gwarancję zgodności z faktami. W ilustracji architektonicznej sprawdź geometrię i charakterystyczne szczegóły budynku przed zatwierdzeniem.
Odróżniaj też możliwości dostawcy od opcji udostępnianych przez aplikację. Funkcja API modelu pomaga w procesie tylko wtedy, gdy używany interfejs ją obsługuje.
Ceny i koszt zaakceptowanego materiału
Google podaje następujące standardowe ceny wyjściowych obrazów Nano Banana 2:
| Rozdzielczość wyniku | Cena obrazu wyjściowego |
|---|---|
| 0.5K | 0,045 USD |
| 1K | 0,067 USD |
| 2K | 0,101 USD |
| 4K | 0,151 USD |
Dane wejściowe, tekstowe wyniki lub rozumowanie oraz płatne zapytania wyszukiwania mogą zwiększać koszt. Ceny przetwarzania wsadowego są niższe. Cennik API Google.
Dla obu wariantów GPT Image 2.5 OpenAI podaje standardowe stawki 5 USD za milion wejściowych tokenów tekstowych, 8 USD za milion wejściowych tokenów obrazowych i 30 USD za milion wyjściowych tokenów obrazowych. Szacunek na obraz zależy od ustawień generowania i wynikowego zużycia. Cennik API OpenAI.
Artificial Analysis podaje około 210,70 USD za 1 000 obrazów dla każdej testowanej konfiguracji GPT Image 2.5 „max” oraz 67 USD za 1 000 obrazów dla Nano Banana 2. To około 3,1× różnicy dla tych konfiguracji, a nie uniwersalna relacja cen. Porównanie cen Artificial Analysis.
Bardziej użyteczną miarą biznesową jest koszt zaakceptowanego materiału: łączne wydatki na generowanie podzielone przez liczbę zaakceptowanych materiałów.
Na przykład hipotetyczne generowanie za 0,07 USD wymagające pięciu prób kosztuje 0,35 USD na zaakceptowany materiał. Generowanie za 0,20 USD zaakceptowane od razu kosztuje łącznie mniej. Żaden przykład nie przewiduje rzeczywistych wskaźników akceptacji tych modeli; pokazuje, dlaczego ponowne próby należą do kalkulacji. Czas ręcznych poprawek śledź osobno.
Quickmake wycenia generowanie w kredytach AI. Bezpośrednie ceny API nie są cenami kredytów Quickmake. Otwórz generator obrazów AI i sprawdź wycenę generatora dla wybranego modelu oraz ustawień.
Wygenerowane przykłady i prompty wielokrotnego użytku
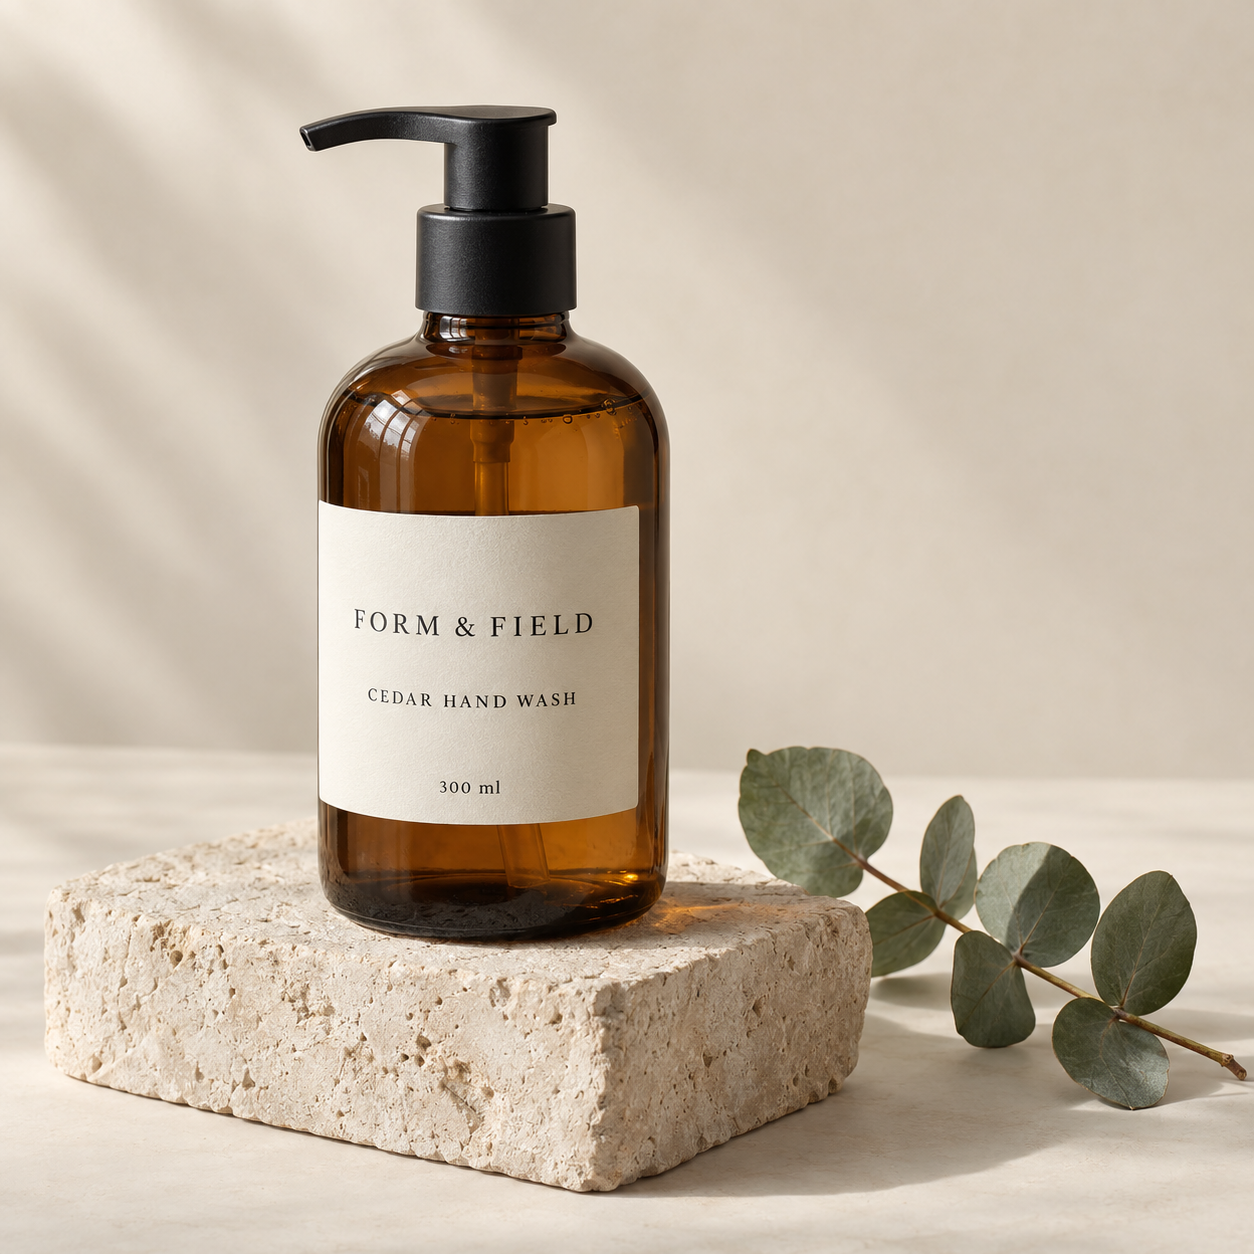
Fotografia produktowa z dokładnymi napisami
Ilustracyjny brief produktowy sprawdzający dokładne napisy, renderowanie materiałów i rozmieszczenie obiektów. Tożsamość modelu jest niezweryfikowana.
Stwórz kwadratowe studyjne zdjęcie jednej bursztynowej szklanej butelki mydła do rąk z matową czarną pompką, stojącej na jasnym wapiennym bloku na ciepłym kremowym tle. Widok z przodu pod kątem trzech czwartych, miękkie światło dzienne z lewego górnego rogu, wiarygodne załamanie światła w szkle i miękki cień kontaktowy. Papierowa etykieta w kolorze kości słoniowej musi zawierać dokładnie trzy wiersze: „FORM & FIELD”, „CEDAR HAND WASH”, „300 ml”. Pompka jest skierowana w lewo. Jedna gałązka eukaliptusa leży na powierzchni po prawej stronie bloku. Powściągliwa redakcyjna fotografia produktowa z realistycznymi drobnymi fakturami. Bez innych obiektów, innych napisów i znaku wodnego.
Wszystkie trzy wymagane wiersze etykiety są czytelne, a pompka wskazuje lewo. Butelka i kamień dają przydatne powierzchnie do sprawdzania odbić oraz faktury. Ponieważ to fikcyjny produkt wygenerowany z tekstu, przykład nie testuje wierności istniejącemu zdjęciu produktu.
Kontrolowana edycja tła
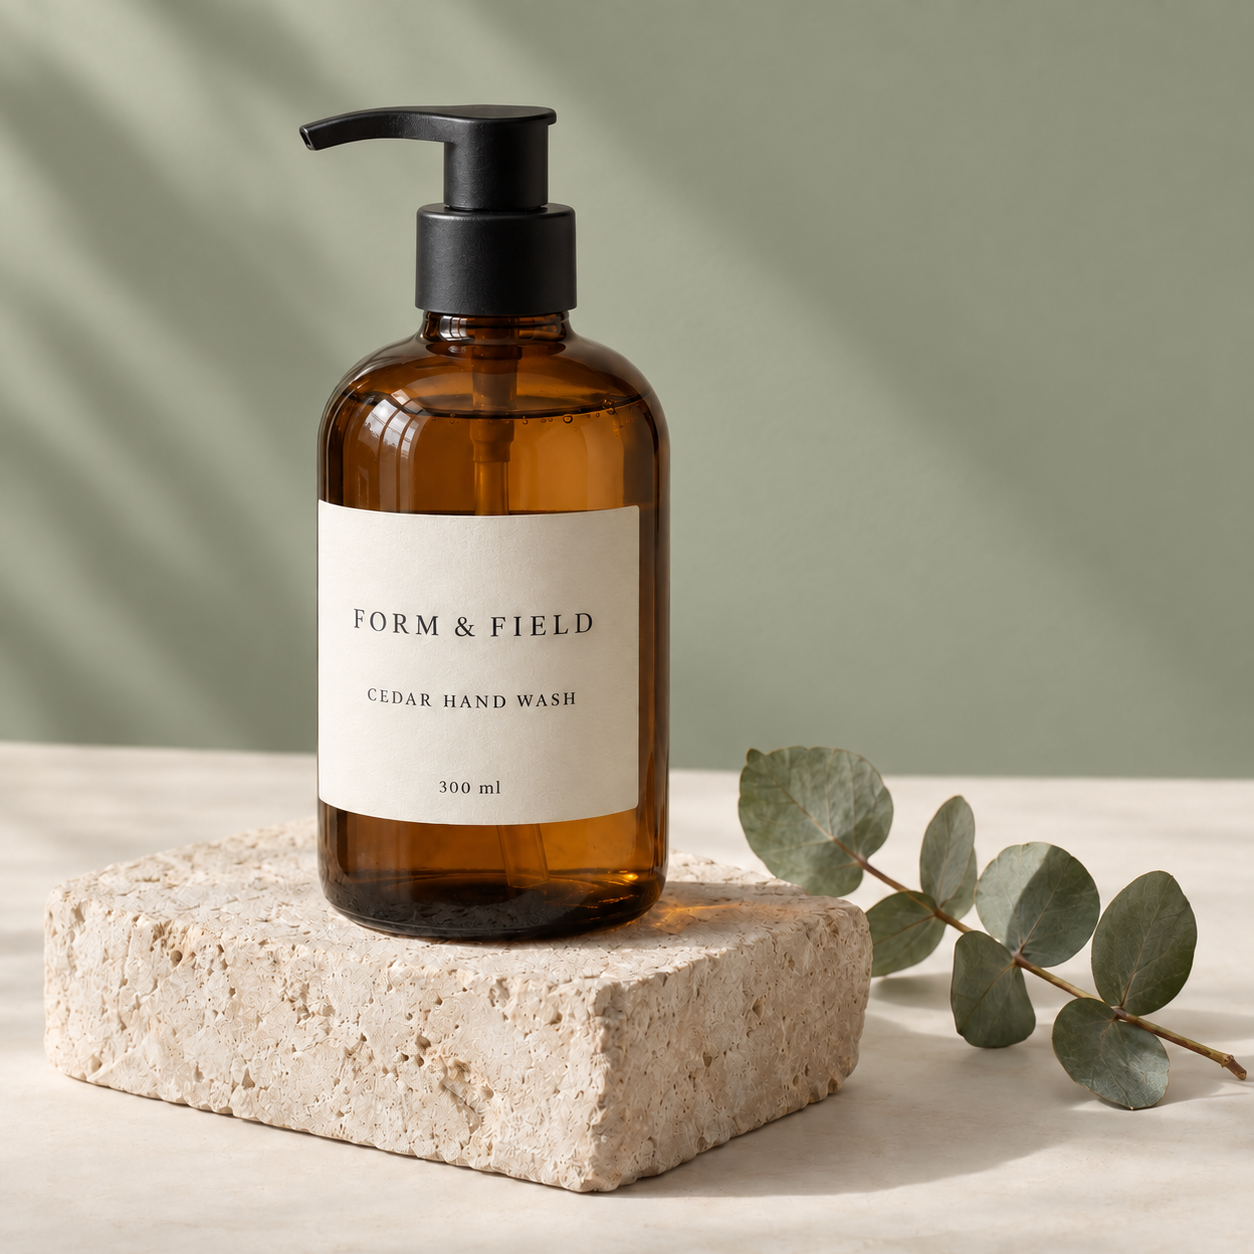
Brief edycji wyłącznie tła z poprzednim obrazem jako materiałem referencyjnym. Porównuj produkt i pierwszy plan równie dokładnie jak zmienioną ścianę.
Zmień wyłącznie kremową ścianę tła na ścianę w przygaszonej zieleni szałwii. Zachowaj bez zmian bursztynową butelkę, jej dokładną sylwetkę i wielkość, czarną pompkę skierowaną w lewo, wszystkie trzy wiersze etykiety („FORM & FIELD”, „CEDAR HAND WASH”, „300 ml”), typografię, fakturę etykiety, wapienny blok, gałązkę eukaliptusa, powierzchnię pierwszego planu, kadr i kąt aparatu. Zachowaj kierunek i miękkość światła. Nie dodawaj ani nie usuwaj żadnych obiektów. Stwórz jedno kwadratowe zdjęcie.
Tło się zmienia, a etykieta pozostaje czytelna. Ogólna kompozycja jest zachowana, lecz zmienia się też część faktury wapienia. Dlatego „wygląda podobnie” i „zachowano wszystko zgodnie z prośbą” wymagają różnych ocen. Używaj tego samego obrazu źródłowego przy porównywaniu trzech nazwanych modeli przez ich rzeczywiste punkty końcowe.
Typografia dwujęzycznego plakatu
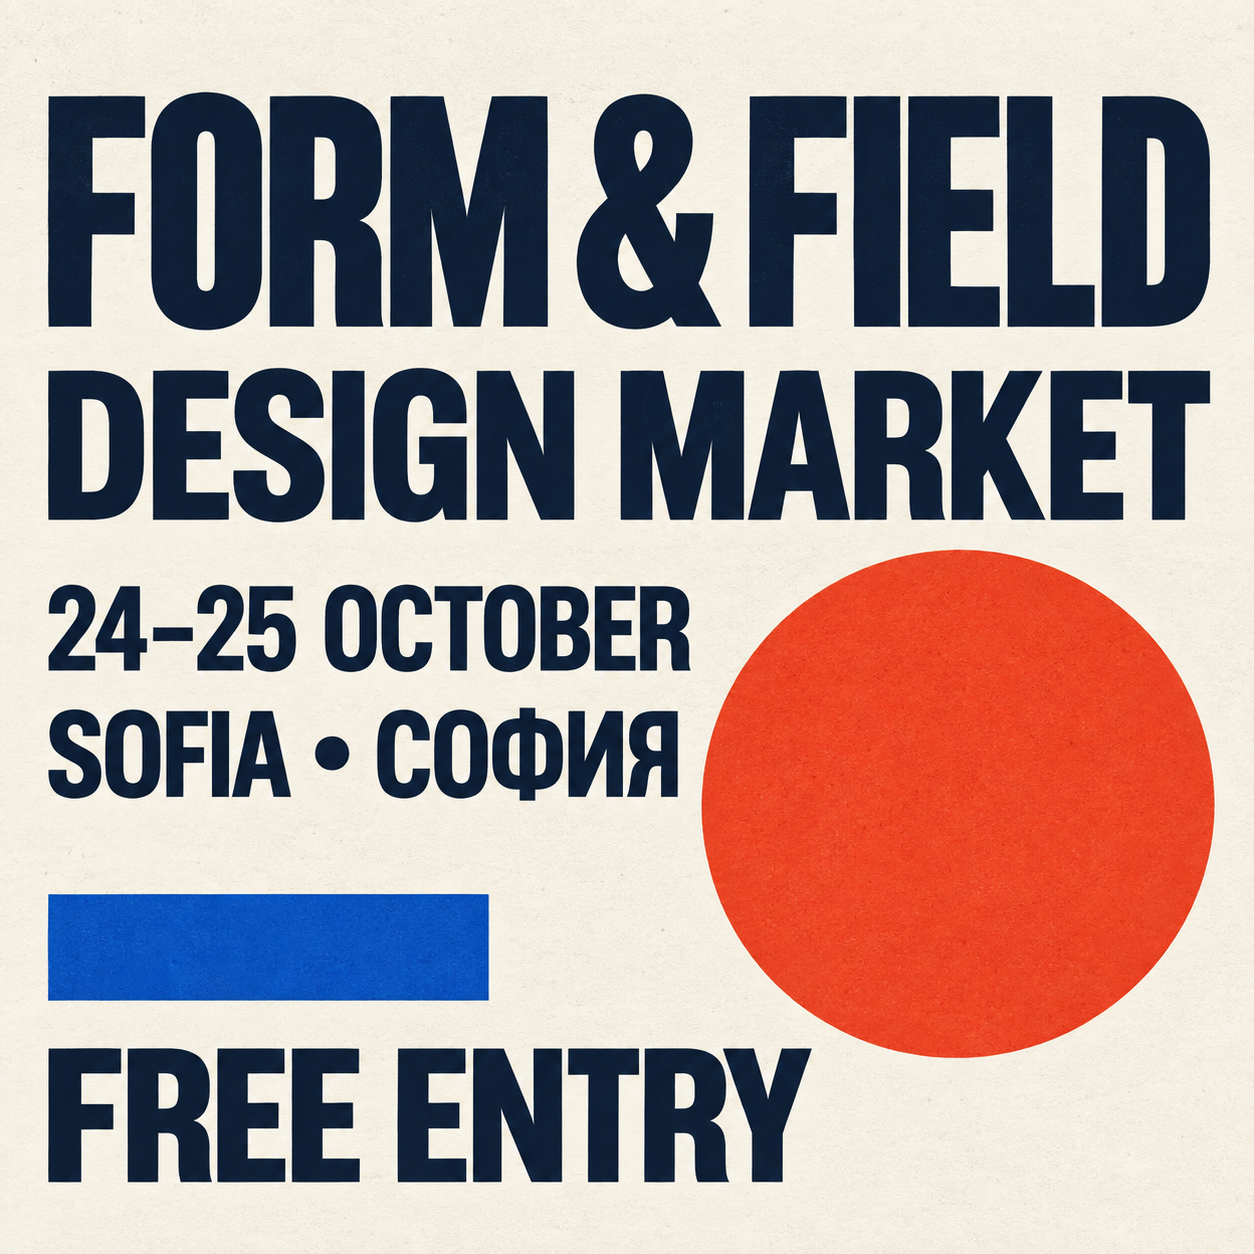
Ilustracyjny dwujęzyczny plakat sprawdzający dokładną treść i hierarchię typograficzną. Wydarzenie jest fikcyjne.
Poniższy polski prompt jest adaptacją ujednoliconego briefu; zapis generowania zachowuje oryginalne angielskie brzmienie użyte do stworzenia obrazu.
Stwórz kwadratowy współczesny plakat targów designu. Ciepły papier w kolorze kości słoniowej z subtelną fakturą druku, duża ciemnogranatowa nowoczesna typografia bezszeryfowa z czytelną hierarchią, wyraziste cynobrowe koło i mały kobaltowy prostokątny akcent. Wyrenderuj dokładnie pięć wierszy: „FORM & FIELD”, „DESIGN MARKET”, „24–25 OCTOBER”, „SOFIA • СОФИЯ”, „FREE ENTRY”. Użyj cyrylicy w „СОФИЯ”. Zrównoważone marginesy i duże odstępy. Płaski projekt graficzny widziany na wprost, bez perspektywicznej makiety, sfotografowanej ramki i znaku wodnego. Typografia jest głównym punktem skupienia.
Wymagana treść wygląda na czytelną, łącznie z nazwą miasta w cyrylicy. Pełna ocena powinna też obejmować kształty znaków, interpunkcję, odstępy i czytelność w docelowym rozmiarze. Pojedynczy udany przykład nie dowodzi niezawodności wielojęzycznej.
Jak porównywać modele na własnej pracy
Użyj tych samych briefów i obrazów źródłowych dla Nano Banana 2, Flare i Sunburst. Zapisz dokładny model, dostawcę, wymiary, ustawienie jakości i informację o włączeniu wyszukiwania. Jeśli ustawień nie można zrównać, opisz różnicę.
Wygeneruj kilka niezależnych wyników na brief i zachowuj porażki obok sukcesów. W miarę możliwości oceniaj wyniki bez etykiet modeli. Punktuj osobno cztery rzeczy:
- Zgodność z instrukcjami: Czy zawiera wymagane elementy i dokładny tekst?
- Jakość wizualna: Czy działa w docelowym rozmiarze dostawy?
- Zachowanie szczegółów: Przy edycji: co zmieniło się poza wymaganym obszarem?
- Nakład produkcyjny: Ile czasu i pieniędzy wymagał zaakceptowany materiał?
Przy edycji daj każdemu modelowi ten sam oryginalny materiał źródłowy. Rozpoczynanie każdego od innego wygenerowanego obrazu dodaje kolejną zmienną. Określ akceptowalny wynik przed oceną i unikaj wybierania jednego atrakcyjnego obrazu przy ukrywaniu powtarzających się niepowodzeń.
Nasza rekomendacja
Zacznij od GPT Image 2.5 Sunburst, gdy w briefie dominują jakość końcowa i precyzja edycji. Cytowane niezależne wyniki wspierają ten wybór. Oceń Flare, gdy liczy się czas realizacji; w części ocen wypada blisko Sunburst i ma niższe opóźnienie w ImageBench.
Oceń Nano Banana 2, gdy znaczenie mają wyszukiwanie, nietypowe proporcje lub ekonomika generowania. Wybieraj na podstawie powtarzalnych sukcesów we własnych briefach, w tym akceptowalnych napisów, zachowanych szczegółów i rozsądnego nakładu poprawek.
Poznaj generator obrazów AI i proces edycji obrazów AI. Przenieś wybrany wynik do edytora projektów, aby dokończyć układ i zachować edytowalny tekst kampanii.